Если последние недели о чём-то говорят, всё больше open source-проектов определяют границы допустимого использования ИИ в своих рабочих процессах и кодовых базах.
Debian недавно проголосовал за возможность использовать генеративный ИИ во вкладе в проект, а Rust принял многоуровневую политику, которая в основном не допускает ИИ в сам код. Оба проекта отвечают на один и тот же принципиальный вопрос.
Теперь Linux, один из крупнейших open source-проектов, страдает от скрейперов, в основном управляемых ИИ. Они снова и снова отправляют одни и те же повторяющиеся запросы и сжигают вычислительные мощности.
К слову, большая часть этой нагрузки вообще не связана с людьми, которые пишут код.
Это абсурд
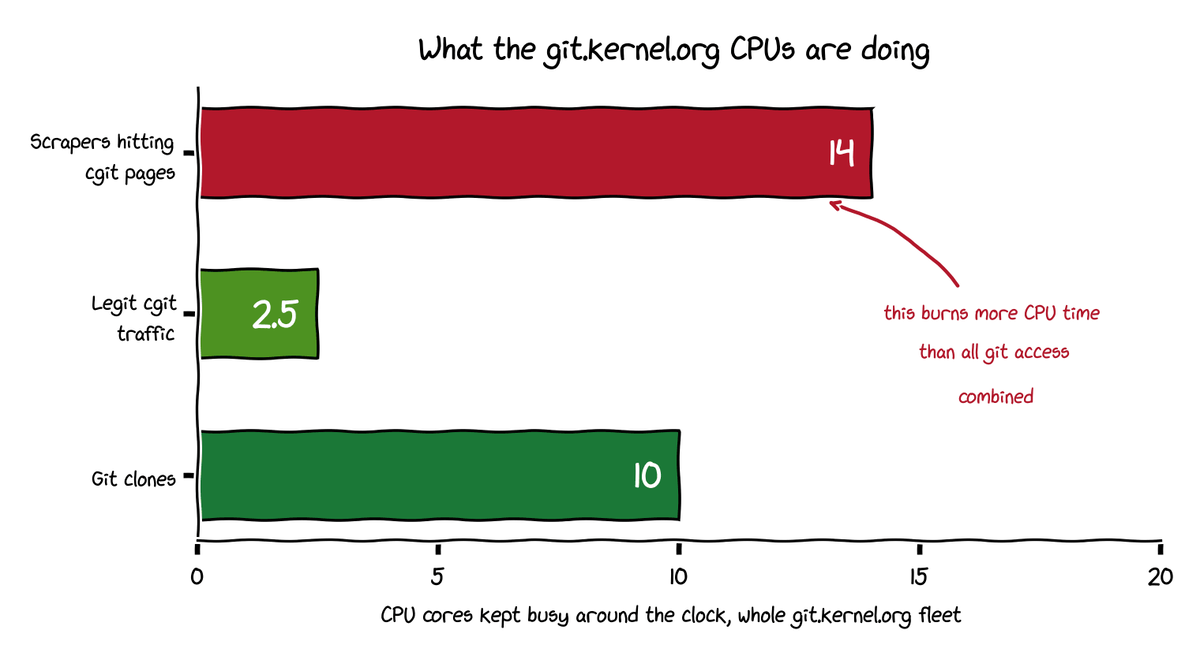
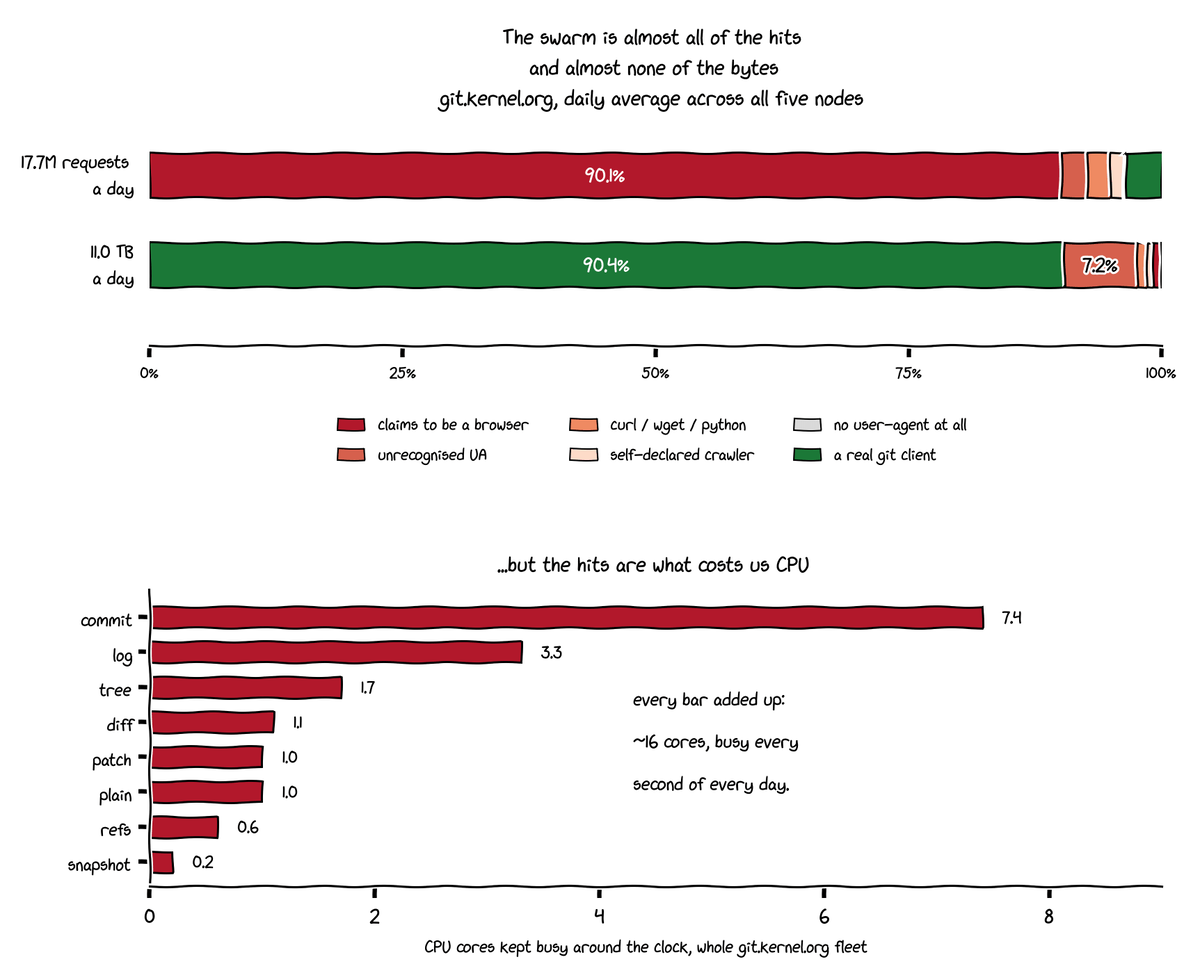
Константин Рябицев из Linux Foundation опубликовал цифры, подтверждающие жалобу, которую он озвучивает уже давно. Четырнадцать из 90 процессорных ядер git.kernel.org, распределённых по пяти узлам, каждую секунду круглосуточно занимаются только тем, что превращают коммиты в HTML-страницы.
На первый взгляд можно задаться вопросом:*** В чём здесь проблема?*** Каждый коммит в истории Linux лежит в открытом доступе, его можно свободно клонировать, и он появился задолго до волны ИИ-инструментов, которые сейчас вычищают этот репозиторий.
Дело в том, что именно эти особенности делают репозиторий “золотая жила данных для обучения.” Он содержит основное дерево ядра, все ветки стабильных релизов за много лет, десятки деревьев мейнтейнеров подсистем и даже историю до перехода на git, сохранившуюся с эпохи BitKeeper.
Абсурднее всего то, как эти “clankers” подходят к сбору данных.
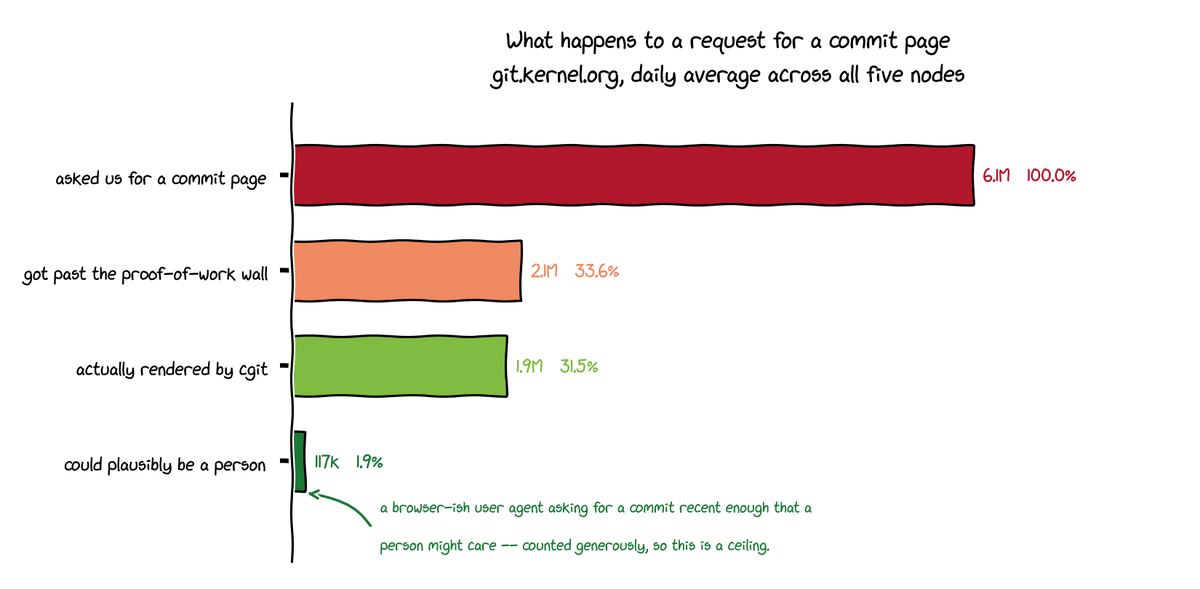
Константин посчитал и выяснил, что обычное клонирование linux.git с локальным проходом по всей истории коммитов занимает около 200 процессорных секунд серверного времени. А сбор тех же 1,48 миллиона коммитов через отдельные страницы cgit съедает 280 процессорных часов.
Если нужно понять, как соотносятся эти две единицы процессорного времени, читайте этот материал.
Если провести такой же сбор по каждому из 922 форков, размещённых на сервере, общий показатель взлетает до** 258,160 процессорных часов**, что примерно в 4,6 миллиона раз дороже одного клонирования.
И всё это ради худшей копии данных, которые и так можно было свободно получить. 🤭
И это ещё без учёта отдельных URL, которые cgit формирует для каждого патча, diff и просмотра коммита в текстовом виде. Именно они увеличивают число страниц, которые отдаёт один форк, до квадриллионов.
Их блокировка превратилась в гонку вооружений. Fail2Ban и баны по IP работали, пока боты не разошлись по целым подсетям. Блокировки по ASN тоже помогали, пока вместо них не появились миллионы домашних и мобильных IP.
Затем появился Anubis. Его развернули как барьер с proof-of-work, который боты должны были преодолеть, прежде чем пройти дальше. Какое-то время это работало, пока скрейперы не начали справляться с задачами растущей сложности.
Завершая материал, Константин отмечает:
Но вам стоит знать, что из 90 ядер, распределённых по 5 географически разнесённым узлам, 14-16 ядер постоянно заняты только отрисовкой коммитов для скрейперов.
В среднем это 20% всей нашей мощности. Правда, рои ботов накатывают волнами, и реальный график гораздо более скачкообразный, чем ровная линия на уровне 20%.
Далее он предполагает, что когда пузырь ИИ лопнет, проект быстро увидит существенное снижение числа “сущностей” (так он называет скрейперов), пытающихся скормить git.kernel.org своим моделям.
При этом он надеется, что они “поумнеют” и перестанут собирать данные “самым глупым из возможных способов.”
Если кто-то не знает, кто такой Константин, он директор по безопасности ИТ-инфраструктуры Linux Foundation и один из системных администраторов, которые поддерживают работу kernel.org.
ИИ по своей природе прожорлив
Такие потери вычислительных ресурсов не уникальны для git.kernel.org. Это просто самый наглядный пример из тех, что мы видели до сих пор.
Обучение модели означает сжигание вычислительных циклов на задачи, которые можно было бы сделать гораздо быстрее. И сейчас тех, кто создаёт такие системы, подобная арифметика, судя по всему, не особо волнует.
Единственный подход, который, похоже, знают такие системы, напоминает образ действий типичного миллиардера, например вымышленного Картера Пьютершмидта. У него уже всего больше, чем нужно. Но он хочет ещё. И его не особенно заботит, каким способом это будет получено.
Если долго идти этим путём, жадность перестаёт окупаться. Многие компании уже убеждаются в этом на собственном опыте, и цифры это подтверждают.
Пока нет комментариев. Будьте первым!